Lógica de Programação – Fluxograma

Desmistificando a Programação: 4 Sacadas Fundamentais que Você Precisa Saber Antes de Escrever Sua Primeira Linha de Código

1. Introdução

Entrar no mundo da tecnologia e do desenvolvimento de sistemas pode parecer intimidador no início, especialmente diante da ideia de ter que lidar com códigos complexos e linguagens desconhecidas. Contudo, o grande segredo para superar essa barreira inicial é entender que, antes de digitar qualquer linha de código, existe uma estrutura lógica simples, visual e extremamente intuitiva por trás de tudo. Dominar essa base é o primeiro passo para organizar suas ideias e tornar o aprendizado da programação algo leve, acessível e muito mais simples do que parece.

2. Ponto 1: Algoritmos são apenas receitas finitas para resolver problemas

Muitas pessoas associam a palavra “algoritmo” a cálculos matemáticos indecifráveis. Na realidade, a lógica de programação envolve o raciocínio necessário para resolver problemas, e o algoritmo é simplesmente a sequência de passos organizada para atingir esse objetivo. Na programação, utilizamos os algoritmos para estruturar o pensamento antes da escrita do código.

“Algoritmo é um conjunto finito de regras, bem definidas, para a solução de um problema em um tempo finito e com um número finito de passos.”

Essa definição é libertadora para quem está começando: ela mostra que programar não é uma arte misteriosa, mas sim o ato de fornecer instruções diretas, claras e delimitadas para o computador, garantindo que o processo tenha um início, um meio e um fim bem determinados.

3. Ponto 2: Desenhar antes de codificar: O poder visual dos Fluxogramas

Antes de traduzir a lógica para uma linguagem de programação, existe uma ferramenta essencial para visualização: o fluxograma. Ele é a representação gráfica de um algoritmo e utiliza símbolos padronizados para demonstrar o fluxo lógico de um programa, permitindo mapear visualmente as etapas de solução de um problema.

Os principais símbolos utilizados em um fluxograma são:

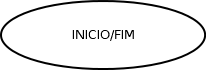
  • Oval: Marca o INÍCIO e o FIM do processo.
  • Retângulo: Representa um Processo (cálculos ou ações executadas).

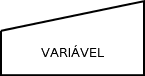
  • Trapézio: Utilizado para a Entrada de dados (leitura de informações e armazenamento na variável).
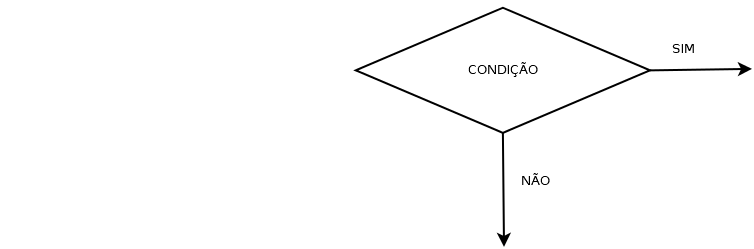
  • Losango: Representa uma Decisão (condições que definem o caminho do fluxo, como Sim/Não ou Verdadeiro/Falso).
  • Setas: Indicam a sequência de execução e a direção do fluxo.
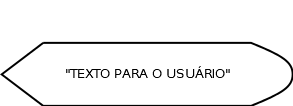
  • Lápis: Indica o texto que será exibido para o usuário do programa (sempre delimitado por aspas duplas).
Visualizar o algoritmo estruturado graficamente funciona como desenhar a planta baixa de uma construção. Esse hábito organiza o raciocínio e previne falhas de lógica antes mesmo do código ser escrito.

4. Ponto 3: Variáveis são as “caixas organizadoras” da memória

Para que um programa seja útil, ele precisa processar informações. É aqui que entram as variáveis: elas são espaços alocados na memória do computador para armazenar dados temporariamente enquanto o programa é executado, permitindo manipular informações como números, textos e resultados de cálculos de forma dinâmica.

Uma variável é definida por duas características fundamentais:

  • Nome: O identificador utilizado para chamar e referenciar a variável ao longo do algoritmo (exemplos: nota, idade, nomeAluno).
  • Valor: O dado específico armazenado naquele espaço de memória em um determinado momento.

As variáveis são responsáveis por dar flexibilidade ao software, permitindo que o mesmo algoritmo processe diferentes dados de entrada e entregue resultados dinâmicos a cada execução.

5. Ponto 4: A tomada de decisões na prática cotidiana dos algoritmos

A inteligência de um software reside na sua capacidade de avaliar condições e seguir caminhos distintos de acordo com os dados recebidos. No desenho do fluxograma, essa tomada de decisão é representada pelo losango, que cria uma bifurcação visual explícita no mapa lógico: dependendo de a condição ser avaliada como Verdadeira/Sim ou Falsa/Não, o programa segue por caminhos de execução completamente diferentes.

Essa estrutura aplica-se diretamente a problemas do dia a dia, como mostram os exemplos a seguir:

  1. Aprovação Escolar: O programa recebe as notas de um aluno, calcula a média e testa a condição no losango (por exemplo, se a média é maior ou igual a 7.0 ou 6.0). Se o resultado for Verdadeiro/Sim, o fluxo segue pelo caminho que exibe “Aprovado”; se for Falso/Não, a seta redireciona a execução para exibir “Reprovado”.
  2. Cálculo de Desconto: Em um sistema de vendas, o algoritmo lê o valor de uma compra e avalia se ele é superior a R$ 100,00. Pelo ramal Verdadeiro/Sim, o fluxo aplica o desconto de 10% sobre o total; pelo ramal Falso/Não, o valor original é mantido sem desconto, exibindo ao final o valor ajustado.

A capacidade de ramificar o fluxo com base em regras predefinidas é o que permite a criação de sistemas computacionais úteis e autônomos.

6. Conclusão

A lógica de programação e a representação por fluxogramas formam a verdadeira base do desenvolvimento de software. Independentemente de qual linguagem de programação você escolha aprender no futuro, a habilidade de fragmentar problemas em passos finitos, organizar dados em variáveis e estruturar tomadas de decisão continuará sendo o seu pilar fundamental.

Agora que você compreendeu como a lógica funciona de forma visual e estruturada, qual processo do seu dia a dia você poderia transformar em um fluxograma hoje?

Funções em PHP: Criação, Uso e Principais Tipos

Funções em PHP: Criação, Uso e Principais Tipos

As funções são um dos recursos mais importantes da linguagem PHP. Elas permitem organizar o código, evitar repetições e tornar a manutenção dos sistemas muito mais simples. Ao criar funções, você pode encapsular uma tarefa específica em um bloco reutilizável, melhorando a legibilidade e a produtividade durante o desenvolvimento.

Neste artigo, vamos aprender como criar funções em PHP e entender os quatro principais cenários de utilização:

  • Com retorno e com parâmetro;
  • Sem retorno e com parâmetro;
  • Com retorno e sem parâmetro;
  • Sem retorno e sem parâmetro.

O que são funções em PHP?

Uma função é um bloco de código que executa uma tarefa específica. Ela pode receber informações (parâmetros), processá-las e retornar um resultado.

A sintaxe básica de uma função em PHP é:

function nomeDaFuncao() {
    // código a ser executado
}

Para executar a função, basta chamá-la pelo nome:

nomeDaFuncao();

1. Função sem retorno e sem parâmetro

Este é o tipo mais simples de função. Ela não recebe dados externos e também não devolve nenhum valor ao programa.

Exemplo

<?php

function exibirMensagem() {
    echo "Bem-vindo ao sistema!";
}

exibirMensagem();

?>

Como funciona?

  • A função exibirMensagem() não recebe parâmetros.
  • Ela apenas exibe uma mensagem na tela usando echo.
  • Não há instrução return.

Quando utilizar?

Esse tipo de função é útil para exibir informações fixas, cabeçalhos, rodapés ou mensagens padronizadas.

2. Função sem retorno e com parâmetro

Nesse caso, a função recebe informações através de parâmetros, mas não retorna um valor.

Exemplo

<?php

function saudar($nome) {
    echo "Olá, $nome! Seja bem-vindo.";
}

saudar("Maria");

?>

Saída

Olá, Maria! Seja bem-vindo.

Como funciona?

  • O parâmetro $nome recebe o valor informado na chamada da função.
  • A função utiliza esse valor para exibir uma mensagem personalizada.
  • Não existe retorno.

Quando utilizar?

É muito comum em funções responsáveis por:

  • Exibir mensagens;
  • Gerar conteúdo HTML;
  • Registrar logs;
  • Enviar notificações.

3. Função com retorno e sem parâmetro

Esse modelo não recebe parâmetros, mas devolve um valor para quem fez a chamada.

Exemplo

<?php

function obterAnoAtual() {
    return date("Y");
}

$ano = obterAnoAtual();

echo "Ano atual: " . $ano;

?>

Saída

Ano atual: 2026

Como funciona?

  • A função busca o ano atual utilizando a função nativa date().
  • O comando return devolve o resultado.
  • O valor retornado é armazenado na variável $ano.

Quando utilizar?

Esse tipo de função é útil para:

  • Obter configurações do sistema;
  • Buscar informações fixas;
  • Retornar dados calculados internamente.

4. Função com retorno e com parâmetro

Este é o modelo mais utilizado em aplicações profissionais. A função recebe dados, processa as informações e devolve um resultado.

Exemplo

<?php

function somar($numero1, $numero2) {
    return $numero1 + $numero2;
}

$resultado = somar(10, 20);

echo "Resultado: " . $resultado;

?>

Saída

Resultado: 30

Como funciona?

  • A função recebe dois parâmetros.
  • Realiza a soma dos valores.
  • Retorna o resultado através de return.

Quando utilizar?

  • Cálculos matemáticos;
  • Processamento de dados;
  • Validações;
  • Regras de negócio.

Entendendo o comando return

O comando return é responsável por devolver um valor ao local onde a função foi chamada.

Exemplo

<?php

function calcularMedia($nota1, $nota2) {
    return ($nota1 + $nota2) / 2;
}

$media = calcularMedia(8, 6);

echo $media;

?>

Resultado

7

Sem o return, a função executaria o cálculo, mas o resultado não poderia ser aproveitado em outras partes do sistema.

Parâmetros e argumentos

Embora muitas pessoas utilizem os termos como sinônimos, existe uma diferença:

  • Parâmetro: variável declarada na função.
  • Argumento: valor enviado na chamada da função.

Exemplo

<?php

function exibirProduto($produto) {
    echo $produto;
}

exibirProduto("Notebook");

?>

Neste exemplo:

  • $produto é o parâmetro;
  • "Notebook" é o argumento.

Funções com parâmetros padrão

Também é possível definir valores padrão para os parâmetros.

Exemplo

<?php

function saudacao($nome = "Visitante") {
    echo "Olá, $nome!";
}

saudacao();
saudacao("Carlos");

?>

Saída

Olá, Visitante!
Olá, Carlos!

Esse recurso evita erros quando nenhum argumento é informado.

Boas práticas ao criar funções

Para manter o código organizado e profissional, siga algumas recomendações:

  • Utilize nomes claros e descritivos.
  • Faça cada função executar apenas uma responsabilidade.
  • Evite funções muito longas.
  • Utilize parâmetros para tornar a função reutilizável.
  • Prefira retornar valores quando o resultado precisar ser aproveitado em outras partes do sistema.
  • Documente funções complexas com comentários.

Exemplos de nomes de funções

calcularSalario();
gerarRelatorio();
validarLogin();

Exemplo prático completo

O exemplo abaixo reúne os quatro tipos de funções estudados.

<?php

// Sem retorno e sem parâmetro
function mensagemSistema() {
    echo "Sistema iniciado.<br>";
}

// Sem retorno e com parâmetro
function exibirUsuario($nome) {
    echo "Usuário: $nome<br>";
}

// Com retorno e sem parâmetro
function obterVersao() {
    return "Versão 1.0";
}

// Com retorno e com parâmetro
function multiplicar($a, $b) {
    return $a * $b;
}

mensagemSistema();

exibirUsuario("João");

echo obterVersao() . "<br>";

echo "Resultado: " . multiplicar(5, 4);

?>

Saída

Sistema iniciado.
Usuário: João
Versão 1.0
Resultado: 20

As funções são elementos fundamentais no desenvolvimento de qualquer linguagem de programação, pois permitem modularizar o código, facilitar a manutenção e promover o reaproveitamento de lógica. Compreender a diferença entre funções que possuem ou não parâmetros e retorno é essencial para criar aplicações mais organizadas e escaláveis.

Ao dominar os quatro modelos apresentados, você estará preparado para construir soluções mais profissionais, reduzindo a repetição de código e aumentando a qualidade dos seus projetos PHP. Seja em sistemas web simples ou aplicações corporativas, o uso adequado de funções é uma prática indispensável para qualquer desenvolvedor PHP.

Sistemas Operacionais nas Empresas

No cenário atual das organizações, a tecnologia da informação deixou de ser apenas um suporte operacional e passou a ocupar papel estratégico nas decisões empresariais. Nesse contexto, os sistemas operacionais (SO) são a base que sustenta toda a infraestrutura tecnológica, sendo essenciais para o funcionamento de computadores, servidores e sistemas corporativos.

Para estudantes do ensino médio técnico em Administração, compreender o funcionamento dos sistemas operacionais é fundamental, pois permite entender como a tecnologia impacta diretamente a produtividade, a organização e a competitividade das empresas.


O que é um Sistema Operacional?

O sistema operacional é um software essencial responsável por gerenciar os recursos de hardware e permitir a execução de aplicações. Ele atua como uma camada intermediária entre o usuário e a máquina, garantindo que todas as operações ocorram de forma organizada e eficiente.

De forma simplificada, o sistema operacional pode ser entendido como o “gerente” do computador, responsável por coordenar tarefas, controlar recursos e garantir que os programas funcionem corretamente.

Principais responsabilidades:

  • Gerencia o processador (CPU)
  • Controla a memória (RAM)
  • Organiza arquivos e dados
  • Gerencia dispositivos conectados
  • Garante segurança e controle de acesso

Arquitetura de um Sistema Operacional

Os sistemas operacionais são compostos por diferentes camadas que trabalham em conjunto para garantir seu funcionamento:

  • Kernel: núcleo do sistema, responsável pelo controle direto do hardware
  • Shell: interface de interação com o usuário
  • Drivers: permitem a comunicação com dispositivos
  • Sistema de arquivos: organiza e gerencia dados

O kernel é a parte mais crítica do sistema operacional, pois controla diretamente os recursos do computador e garante a execução correta das tarefas.


Principais Funções do Sistema Operacional

1. Gerenciamento de Processos

Permite que vários programas sejam executados simultaneamente, distribuindo o uso da CPU de forma equilibrada. Esse processo é conhecido como multitarefa.

2. Gerenciamento de Memória

Controla o uso da memória RAM, evitando conflitos entre programas e garantindo eficiência na execução.

3. Gerenciamento de Arquivos

Organiza os dados em diretórios e arquivos, permitindo acesso rápido e seguro às informações.

4. Gerenciamento de Dispositivos

Controla periféricos como impressoras, scanners e dispositivos USB, garantindo seu funcionamento adequado.

5. Segurança

Define permissões de acesso, protege dados e evita acessos indevidos.


Tipos de Sistemas Operacionais

Os sistemas operacionais podem ser classificados de diferentes formas:

  • Monotarefa: executa uma tarefa por vez
  • Multitarefa: executa várias tarefas simultaneamente
  • Multiusuário: permite múltiplos usuários
  • Distribuído: funciona em vários computadores interligados
  • Tempo real: utilizado em sistemas críticos (ex: hospitais, indústria)

Principais Sistemas Operacionais no Mercado

Windows

Dominante no ambiente corporativo, possui ampla compatibilidade com softwares administrativos e facilidade de uso.

Linux

Amplamente utilizado em servidores e ambientes corporativos críticos devido à sua estabilidade, segurança e baixo custo.

macOS

Utilizado em dispositivos Apple, com foco em desempenho e integração.


Sistemas Operacionais e a Gestão Empresarial

Na Administração, os sistemas operacionais são fundamentais para o funcionamento de sistemas corporativos como:

  • ERP (Planejamento de Recursos Empresariais)
  • Sistemas financeiros
  • Controle de estoque
  • CRM (gestão de clientes)

Esses sistemas dependem diretamente do sistema operacional para processar dados e gerar informações para a tomada de decisão.


Impacto na Produtividade e Eficiência

Um sistema operacional eficiente proporciona:

  • Redução de tempo em tarefas operacionais
  • Melhor desempenho dos sistemas
  • Menor ocorrência de falhas
  • Maior organização dos dados

Por outro lado, sistemas mal configurados podem gerar lentidão, erros e prejuízos financeiros.


Segurança da Informação

Os sistemas operacionais desempenham papel essencial na segurança empresarial, incluindo:

  • Controle de acesso por usuário
  • Atualizações de segurança
  • Proteção contra malware
  • Criptografia de dados

Empresas que não mantêm seus sistemas atualizados ficam mais vulneráveis a ataques cibernéticos.


Virtualização e Computação em Nuvem

Com o avanço da tecnologia, os sistemas operacionais passaram a ser utilizados em ambientes virtualizados e em nuvem, permitindo:

  • Redução de custos com infraestrutura
  • Escalabilidade de sistemas
  • Acesso remoto
  • Maior flexibilidade operacional

Tendências Tecnológicas

  • Integração com inteligência artificial
  • Sistemas mais leves e rápidos
  • Maior foco em segurança digital
  • Automação de processos

Programação Orientada a Objetos

Programação Orientada a Objetos: 5 Lições Essenciais que Vão Mudar sua Forma de Codar

1. Introdução: O Caos vs. A Ordem

Imagine um labirinto de código onde cada nova funcionalidade adicionada parece um castelo de cartas prestes a desmoronar. No início da era do software, a programação procedural nos forçava a escrever sequências intermináveis de comandos e funções soltas que, embora funcionais em sistemas pequenos, tornavam-se um pesadelo de manutenção conforme a complexidade crescia. O “código espaguete” não era apenas um mito, era a realidade de quem tentava gerenciar estados globais e fluxos de dados imprevisíveis. A Programação Orientada a Objetos (POO) surgiu não como uma regra acadêmica árida, mas como uma arquitetura de libertação, permitindo-nos organizar o caos ao espelhar a lógica do mundo real dentro das máquinas.

Em vez de pensarmos apenas em “o que o programa faz”, passamos a projetar “quem são os atores”. Pense em um sistema de biblioteca: no mundo real, não temos apenas processos de data e devolução; temos entidades tangíveis como o Livro, o Usuário e o Empréstimo. Cada um possui suas próprias características e responsabilidades. Na POO, transformamos essas entidades em objetos que interagem entre si, criando um ecossistema digital intuitivo, onde o código deixa de ser um conjunto de instruções abstratas e passa a ser um modelo fiel da realidade.

2. Lição 1: O Código como Espelho da Realidade (Classe vs. Objeto)

Para um Arquiteto de Software, a base de um sistema robusto reside na distinção clara entre o projeto e a execução. Usamos a Classe como o nosso “molde” ou “blueprint” — ela define o potencial de um elemento, descrevendo seus atributos (dados) e métodos (comportamentos). O Objeto, por sua vez, é a materialização desse molde, uma instância viva que ocupa espaço na memória e possui identidade própria.

Tomemos o Carro como exemplo técnico. A classe define que todo carro deve ter cor e modelo, além da capacidade de acelerar. No entanto, é apenas quando instanciamos essa classe que temos, de fato, um Civic preto estacionado em nossa memória volátil.

class Carro { 
    public string modelo; 
    public string cor;

    public void Acelerar() {
        // Lógica para aumentar a velocidade
    }

    public void Frear() {
        // Lógica para reduzir a velocidade
    }
}

// Criando uma instância (Objeto):
Carro carro1 = new Carro();
carro1.modelo = "Civic"; 
carro1.cor = "Preto";

// O objeto executa uma ação definida na sua classe:
carro1.Acelerar(); 

Dica de Arquiteto: Organizar o código desta forma não é apenas estética; é sobre coesão. Ao agrupar dados e comportamentos relacionados, reduzimos drasticamente o esforço cognitivo necessário para entender o sistema, permitindo que novos desenvolvedores naveguem pela arquitetura com a mesma facilidade com que identificariam um carro em uma rua.

3. Lição 2: A Segurança Blindada do Encapsulamento

O encapsulamento é o primeiro grande pilar da proteção de software. Do ponto de vista arquitetural, expor todos os dados de um objeto é um convite ao desastre e à corrupção de estado. O uso do modificador private é a nossa ferramenta de blindagem, garantindo que o estado interno de um objeto só possa ser alterado por ele mesmo, sob regras estritas.

Considere uma Conta Bancária. Em um sistema vulnerável, qualquer parte do código poderia simplesmente sobrescrever o valor do saldo. Na POO profissional, o saldo é marcado como private (representado pelo símbolo - em diagramas UML), e o acesso é mediado por métodos públicos (+) como Depositar() e Sacar().

“Encapsulamento significa proteger os dados do objeto, permitindo acesso apenas de forma controlada.”

Ao utilizar métodos para mediar o acesso, o objeto pode validar se um saque é permitido antes de atualizar o saldo. Dica de Arquiteto: Isso reduz o acoplamento sistêmico. Se a regra de cálculo de juros mudar amanhã, você altera apenas o método interno do objeto, sem precisar caçar e consertar centenas de referências espalhadas pelo sistema.

4. Lição 3: O Poder de Múltiplas Formas (Polimorfismo)

O polimorfismo é a capacidade de tratar diferentes tipos de objetos através de uma interface comum, permitindo que um mesmo método se comporte de formas distintas. É aqui que o software ganha sua verdadeira elegância e extensibilidade.

Imagine uma classe base Animal que define um contrato via método EmitirSom(). Usando as palavras-chave virtual (na base) e override (na derivada), garantimos que o Cachorro lata e o Gato mie, mesmo que o sistema os esteja tratando genericamente apenas como “Animais”.

Dica de Arquiteto: O polimorfismo é o segredo por trás do Princípio Aberto/Fechado (Open/Closed Principle). Ele permite que você adicione novas funcionalidades (como um novo animal) sem precisar modificar o código que já funciona. Você estende o sistema sem quebrar o que já está consolidado.

5. Lição 4: A Vida e a Morte dos Objetos (Composição vs. Agregação)

Um erro comum de iniciantes é ignorar o ciclo de vida das relações entre objetos. Para um arquiteto, entender a “posse” é fundamental para a gestão de memória e integridade referencial:

  • Agregação (Relação Fraca): Uma Universidade possui Professores. Se a universidade for extinta, os professores continuam existindo. Eles são entidades independentes que apenas colaboram temporariamente.
  • Composição (Relação Forte): Uma Casa possui Quartos. Se a casa for demolida, os quartos deixam de existir instantaneamente. O ciclo de vida do quarto está intrinsecamente ligado ao da casa.

Dica de Arquiteto: Ignorar essa diferença leva a “vazamentos de memória” e registros órfãos no banco de dados. Ao desenhar seu sistema, pergunte-se sempre: “Se o pai morrer, os filhos devem sobreviver?”. A resposta definirá se você usará uma agregação ou uma composição.

6. Lição 5: Menos é Mais – O Caminho das Boas Práticas

Para ascender ao nível de um desenvolvedor de elite, você deve adotar princípios que privilegiam a manutenção a longo prazo. Siga este manifesto:

  • Responsabilidade Única: Uma classe deve ter apenas um motivo para mudar. Se sua classe Usuario também envia e-mails e gera relatórios em PDF, ela está sobrecarregada.
  • Evite Repetição (DRY – Don’t Repeat Yourself): Use a herança para compartilhar comportamentos comuns, mas com cautela.
  • Nomes Claros: O código deve ser lido como prosa. Processar() é vago; ValidarSaldoParaTransferencia() é autoexplicativo.
  • Prefira Composição sobre Herança: A herança cria uma dependência rígida (o problema da “classe base frágil”). A composição permite que você monte comportamentos como blocos de LEGO, tornando o sistema muito mais modular e plugável.

Conclusão: O Próximo Passo na sua Jornada

Dominar a Programação Orientada a Objetos é como aprender a ler as plantas de um edifício antes de começar a assentar os tijolos. Através de seus pilares e do uso estratégico de diagramas UML, você se torna capaz de prever falhas estruturais e projetar sistemas que não apenas funcionam, mas que evoluem com saúde ao longo dos anos.

Agora que você entende que o código pode imitar a vida em toda a sua complexidade e ordem, qual entidade do seu dia a dia você transformaria em um objeto hoje para facilitar sua rotina?

Sistema Operacionais na gestão administrativa

1. Introdução e Conceituação Técnica

Sob a ótica da consultoria de TI voltada à gestão, o Sistema Operacional (SO) deve ser compreendido como a camada fundamental de inteligência que viabiliza toda a operação corporativa. Ele não é apenas um software, mas o intermediário crítico que orquestra a comunicação entre o hardware, os aplicativos de produtividade e o usuário final, garantindo que os recursos tecnológicos sejam convertidos em valor administrativo.

O Sistema Operacional é o software responsável por gerenciar o funcionamento do computador, atuando como o núcleo central de comando de toda a infraestrutura digital.

2. Tipos de Sistemas Operacionais e Categorização

Para uma gestão eficiente, é necessário adequar o tipo de sistema à função desempenhada. No ecossistema administrativo, classificamos os sistemas da seguinte forma:

  • Desktop: Plataformas voltadas para estações de trabalho e produtividade individual.
    • Exemplos: Windows, Linux e macOS.
  • Servidor: Sistemas robustos projetados para centralizar serviços, hospedar bancos de dados e gerenciar redes empresariais.
    • Exemplos: Windows Server e Linux Server.
  • Mobile: Essenciais para a mobilidade corporativa e acesso rápido a informações em trânsito.
    • Exemplos: Android e iOS.
  • Baseados em Nuvem: Soluções emergentes que operam via infraestrutura remota, permitindo que a lógica de processamento ocorra fora do hardware local, otimizando custos de manutenção.

3. Características e Atributos do Sistema

Abaixo, detalho os atributos técnicos essenciais e como eles impactam diretamente a eficiência da gestão:

CaracterísticaDescrição Técnica e Benefício Administrativo
Interface Gráfica (GUI)Ambiente visual intuitivo que utiliza ícones e menus. Impacto: Reduz drasticamente a curva de aprendizado da equipe e acelera a execução de tarefas rotineiras.
MultitarefaCapacidade de processar múltiplas instruções simultaneamente. Impacto: Permite que o gestor opere softwares de ERP, planilhas e comunicações ao mesmo tempo, sem perda de fluidez.
MultiusuárioSuporte a diferentes perfis de acesso no mesmo sistema. Impacto: Essencial para a governança, permitindo auditar quem acessou determinadas informações e isolar dados sensíveis.
SegurançaProtocolos nativos de proteção e controle. Impacto: Garante a blindagem primária contra acessos não autorizados e protege o patrimônio intelectual da empresa.
CompatibilidadeCapacidade de suporte a diversas aplicações. Impacto: Assegura que ferramentas administrativas específicas (contábeis, RH, CRM) funcionem de forma integrada e estável.

4. Funções Básicas e Gerenciamento de Recursos

O SO atua como o “Gerente de Operações” do hardware. Suas quatro funções vitais são a base para a estabilidade do setor administrativo:

  1. Gerenciamento de arquivos: Organiza e recupera dados, sendo a base técnica para toda a organização documental da empresa.
  2. Gerenciamento de memória: Coordena a distribuição de RAM, garantindo que softwares pesados de gestão não causem interrupções ou travamentos.
  3. Gerenciamento de processos: Prioriza a execução de tarefas do processador, otimizando o tempo de resposta do sistema.
  4. Gerenciamento de segurança: Controla o fluxo de privilégios, atuando como a primeira barreira contra vulnerabilidades internas e externas.

5. Aplicação Prática no Ambiente Empresarial

Para o administrador, o Sistema Operacional é o gestor da lógica corporativa. Sua implementação correta sustenta quatro pilares fundamentais:

  • Controle de acesso: Definir quem pode visualizar ou editar dados financeiros e estratégicos.
  • Organização de documentos: Estruturação lógica que evita a perda de prazos e informações críticas.
  • Instalação de softwares administrativos: Provimento de um ecossistema estável para ferramentas de produtividade.
  • Proteção de dados: Salvaguarda dos ativos informacionais contra falhas técnicas ou humanas.

6. Segurança da Informação e Gestão de Riscos

6.1. Princípios Fundamentais A segurança deve ser pautada na tríade clássica, aplicada ao cotidiano do escritório:

  • Confidencialidade: Garantir que dados sensíveis (como folhas de pagamento) sejam acessíveis apenas por pessoal autorizado.
  • Integridade: Assegurar que as informações não sejam alteradas indevidamente, mantendo a precisão dos registros contábeis.
  • Disponibilidade: Garantir que o sistema e os dados estejam prontos para uso sempre que a operação exigir.

6.2. Boas Práticas Operacionais Recomendo a adoção imediata das seguintes diretrizes:

  • Implementar políticas de senhas fortes e rotativas.
  • Assegurar a instalação e monitoramento constante de antivírus.
  • Monitorar e aplicar atualizações de sistema rigorosamente para corrigir brechas de segurança.

7. Estratégias de Backup e Armazenamento em Nuvem

7.1. Modalidades de Backup Backup é a cópia de salvaguarda indispensável para a continuidade do negócio. Devemos configurar:

  • Completo: Uma cópia integral de todo o repositório de dados.
  • Incremental: Cópia apenas do que foi alterado desde o último backup, otimizando tempo e espaço.
  • Automático: Rotinas programadas que eliminam a falha humana e garantem a periodicidade das cópias.

7.2. Vantagens da Nuvem O armazenamento em nuvem é uma recomendação estratégica, pois permite o acesso remoto (essencial para regimes híbridos) e oferece uma segurança reforçada contra sinistros físicos, como roubos de hardware ou danos elétricos no escritório local.

8. Atividades Práticas de Implementação Administrativa

Propomos o seguinte plano de ação para alinhar a tecnologia aos processos de gestão:

  • Fase 1: Estruturação Organizacional: Criação de uma hierarquia lógica de pastas e diretórios baseada nos departamentos da empresa, facilitando a recuperação de informações.
  • Fase 2: Validação de Resiliência: Simulação de rotinas de backup em nuvem para testar o tempo de recuperação e a integridade dos dados salvos.
  • Fase 3: Diagnóstico de Segurança: Realização de uma análise técnica de riscos para identificar vulnerabilidades e pontos de melhoria na proteção da informação.

Conectando C# ao MySQL com DLL e fazendo um CRUD

Pré-requisitos

MySQL Server instalado (pode ser local ou remoto).

Visual Studio (Community é suficiente) ou Visual Studio Code com .NET SDK.

Conta no MySQL com permissão para um banco de testes.

DLL manual

Baixe o MySQL Connector/NET, pegue o arquivo MySql.Data.dll e, no Visual Studio:
Project > Add Reference… > Browse e aponte para a DLL.

Iniciando o projeto C#

Crie um Console App e adicione a DLL baixada fique atento a versão da dll,ela deve ser compativel com a versão do dotnet framework usada.

using MySql.Data.MySqlClient;

public static class Db
{
    // Versão simples com string fixa (didática)
    private const string CS = "Server=localhost;Port=3306;Database=escola;User Id=aluno;Password=123;SslMode=None;CharSet=utf8mb4;";

    public static MySqlConnection GetConnection()
    {
        var cn = new MySqlConnection(CS);
        cn.Open();
        return cn;
    }
}

Observações:

  • SslMode=None desabilita o acesso ao sgbd por SSL
  • CharSet=utf8mb4 garante acentuação correta.

Desbravando o Vi: Comandos Cruciais

ComandoDescrição
h, j, k, lMovimenta o cursor para esquerda, baixo, cima e direita, respectivamente.
0 (zero)Move o cursor para o início da linha.
$Move o cursor para o final da linha.
wAvança para a próxima palavra.
bRetrocede para a palavra anterior.
GVai para a última linha do arquivo.
ggVai para a primeira linha do arquivo.
iEntra no modo de inserção antes do cursor.
aEntra no modo de inserção após o cursor.
OAdiciona uma nova linha acima da linha atual e entra no modo de inserção.
oAdiciona uma nova linha abaixo da linha atual e entra no modo de inserção.
EscSai do modo de inserção para o modo de comando.
xApaga o caractere sob o cursor.
dwApaga da posição atual do cursor até o final da palavra.
ddApaga a linha atual.
DApaga da posição atual do cursor até o final da linha.
uDesfaz a última ação.
Ctrl + rRefaz a última ação desfeita.
yyCopia a linha atual.
pCola o conteúdo copiado abaixo do cursor.
PCola o conteúdo copiado acima do cursor.
ywCopia a palavra sob o cursor.
ddpRecorta a linha atual e cola abaixo da linha onde o cursor está posicionado.
yw ou y$Copia a palavra ou trecho de texto até o final da linha.
/Inicia uma busca no documento.
?Inicia uma busca no documento na direção oposta.
nAvança para a próxima ocorrência da palavra buscada.
NRetrocede para a ocorrência anterior da palavra buscada.
:s/old/new/gSubstitui todas as ocorrências de “old” por “new” na linha atual.
:%s/old/new/gSubstitui todas as ocorrências de “old” por “new” no arquivo inteiro.
:%s/old/new/gcSubstitui todas as ocorrências de “old” por “new” no arquivo inteiro com confirmação.

Mysql Comandos básicos para criar tabelas

MySQL é um sistema de gerenciamento de banco de dados (SGBD) popular que suporta vários tipos de dados. Neste artigo, vamos discutir os principais tipos de dados em MySQL com exemplos.

  1. INTEGER – O tipo de dados INTEGER é usado para armazenar números inteiros. Você pode especificar o tamanho do INTEGER, que pode variar de 1 a 8 bytes. O tamanho padrão é 4 bytes. Exemplo:
sql
CREATE TABLE clientes (
    id INTEGER,
    nome VARCHAR(50),
    idade INTEGER
);
  1. VARCHAR – O tipo de dados VARCHAR é usado para armazenar uma string de caracteres variáveis. Você deve especificar o tamanho máximo da string. Exemplo:
sql
CREATE TABLE clientes (
    id INTEGER,
    nome VARCHAR(50),
    endereco VARCHAR(100)
);
  1. DATE – O tipo de dados DATE é usado para armazenar datas. Exemplo:
sql
CREATE TABLE vendas (
    id INTEGER,
    data_venda DATE,
    total_venda DECIMAL(10, 2)
);
  1. DECIMAL – O tipo de dados DECIMAL é usado para armazenar números decimais. Você deve especificar o tamanho total e o número de dígitos após o ponto decimal. Exemplo:
sql
CREATE TABLE vendas (
    id INTEGER,
    data_venda DATE,
    total_venda DECIMAL(10, 2)
);
  1. BOOLEAN – O tipo de dados BOOLEAN é usado para armazenar valores lógicos verdadeiro ou falso (1 ou 0). Exemplo:
sql
CREATE TABLE usuarios (
    id INTEGER,
    nome VARCHAR(50),
    ativo BOOLEAN
);
  1. BLOB – O tipo de dados BLOB é usado para armazenar grandes quantidades de dados binários, como imagens ou arquivos de áudio. Exemplo:
sql
CREATE TABLE produtos (
    id INTEGER,
    nome VARCHAR(50),
    imagem BLOB
);

Esses são apenas alguns dos principais tipos de dados em MySQL. Ao criar tabelas em MySQL, é importante escolher o tipo de dados correto para cada coluna com base no tipo de dado que será armazenado. Isso ajudará a otimizar o desempenho e garantir a integridade dos dados.

Aqui estão mais exemplos de tipos de dados em MySQL, incluindo exemplos de data e hora:

  1. TIME – O tipo de dados TIME é usado para armazenar um horário. Exemplo:
sql
CREATE TABLE compromissos (
    id INTEGER,
    titulo VARCHAR(50),
    hora TIME
);
  1. DATETIME – O tipo de dados DATETIME é usado para armazenar uma data e hora. Exemplo:
sql
CREATE TABLE compromissos (
    id INTEGER,
    titulo VARCHAR(50),
    data_hora DATETIME
);
  1. TIMESTAMP – O tipo de dados TIMESTAMP é usado para armazenar uma data e hora, semelhante ao DATETIME. No entanto, o valor TIMESTAMP é armazenado como um valor inteiro UNIX, que é convertido em uma data e hora quando recuperado. Exemplo:
sql
CREATE TABLE logs (
    id INTEGER,
    mensagem VARCHAR(200),
    data_hora TIMESTAMP
);
  1. YEAR – O tipo de dados YEAR é usado para armazenar um ano com quatro dígitos. Exemplo:
sql
CREATE TABLE livros (
    id INTEGER,
    titulo VARCHAR(100),
    ano_publicacao YEAR
);

Ao usar tipos de dados de data e hora, é importante ter em mente que o formato de data e hora pode variar dependendo do local e da configuração do servidor. Além disso, pode ser necessário converter valores de data e hora entre formatos diferentes ao trabalhar com diferentes sistemas ou linguagens de programação.

Foreign Key ( Chave Estrangeira)

Uma chave estrangeira (FOREIGN KEY) no MySQL é um campo (ou conjunto de campos) em uma tabela que faz referência à chave primária (PRIMARY KEY) de outra tabela. O seu objetivo principal é estabelecer um vínculo entre duas tabelas e garantir a integridade referencial dos dados.


Conceitos Principais

  • Integridade Referencial: Impede a inserção de valores na tabela de destino (tabela filha) que não existam na tabela referenciada (tabela pai), evitando registros órfãos.
  • Relacionamento Pai e Filho: A tabela que contém a chave primária é chamada de tabela pai ou referenciada; a tabela que contém a chave estrangeira é a tabela filha.
  • Mecanismo de Armazenamento: No MySQL, o suporte padrão e completo a chaves estrangeiras requer o uso do engine InnoDB.

Exemplos Práticos de Sintaxe

1. Criando a chave estrangeira junto com a tabela (CREATE TABLE)

-- Tabela Pai (Pessoa)
CREATE TABLE Pessoa (
    ID_Pessoa INT PRIMARY KEY AUTO_INCREMENT,
    Nome VARCHAR(255) NOT NULL
);

-- Tabela Filha (Carro) com a Chave Estrangeira
CREATE TABLE Carro (
    ID_Carro INT PRIMARY KEY AUTO_INCREMENT,
    Modelo VARCHAR(255),
    ID_Pessoa INT,
    CONSTRAINT fk_Pessoa_Carro FOREIGN KEY (ID_Pessoa) REFERENCES Pessoa(ID_Pessoa)
) ENGINE = InnoDB;

2. Adicionando uma chave estrangeira a uma tabela existente (ALTER TABLE)

ALTER TABLE Carro
ADD CONSTRAINT fk_Pessoa_Carro
FOREIGN KEY (ID_Pessoa) REFERENCES Pessoa(ID_Pessoa);

Comandos Básicos Prompt de Comando do Windows

No Windows, um diretório é uma pasta que contém arquivos e outras subpastas. Ele é usado para organizar e armazenar arquivos de maneira lógica e hierárquica, permitindo que os usuários acessem e gerenciem seus arquivos de forma eficiente.

Os diretórios são representados graficamente como pastas no explorador de arquivos do Windows. Você pode criar, renomear, mover, copiar e excluir diretórios, assim como criar e manipular arquivos dentro deles.

Os diretórios são organizados em uma estrutura de árvore, onde um diretório pai pode conter vários diretórios filhos. Por exemplo, a pasta “Documentos” pode conter subpastas para diferentes tipos de arquivos, como “Fotos”, “Música” e “Trabalho”. Cada uma dessas subpastas pode, por sua vez, conter suas próprias subpastas e arquivos.

A hierarquia de diretórios no Windows permite que os usuários organizem seus arquivos de forma lógica e fácil de entender, facilitando o acesso e o gerenciamento desses arquivos.

O prompt de comando do Windows, ou cmd, é uma ferramenta poderosa que pode ser usada para manipular arquivos em seu sistema operacional Windows. Neste artigo, vamos discutir alguns dos comandos básicos que você pode usar para manipular arquivos usando o cmd.

  1. CD – O comando CD (Change Directory) é usado para mudar o diretório atual. Por exemplo, se você quiser mudar o diretório atual para a pasta “Documentos”, basta digitar “cd documentos” no prompt de comando. Para voltar ao diretório anterior digite CD .. .
  2. DIR – O comando DIR é usado para listar os arquivos e pastas no diretório atual. Para listar todos os arquivos e pastas no diretório atual, digite “dir”.
  3. MD – O comando MD (Make Directory) é usado para criar um novo diretório. Por exemplo, se você quiser criar um novo diretório chamado “Meus Arquivos”, basta digitar “md Meus Arquivos”.
  4. RD – O comando RD (Remove Directory) é usado para remover um diretório vazio. Por exemplo, se você quiser remover o diretório “Meus Arquivos”, basta digitar “rd Meus Arquivos”.
  5. COPY – O comando COPY é usado para copiar um arquivo de um local para outro. Por exemplo, se você quiser copiar um arquivo chamado “documento.txt” do diretório “Documentos” para o diretório “Meus Arquivos”, basta digitar “copy documentos.txt Meus Arquivos”.
  6. DEL – O comando DEL (Delete) é usado para excluir um arquivo. Por exemplo, se você quiser excluir um arquivo chamado “documento.txt” do diretório “Documentos”, basta digitar “del documentos.txt”.
  7. MOVE – O comando MOVE é usado para mover um arquivo de um local para outro. Por exemplo, se você quiser mover um arquivo chamado “documento.txt” do diretório “Documentos” para o diretório “Meus Arquivos”, basta digitar “move documentos.txt Meus Arquivos”.
  8. REN – O comando REN (Rename) é usado para renomear um arquivo. Por exemplo, se você quiser renomear um arquivo chamado “documento.txt” para “meu_documento.txt”, basta digitar “ren documento.txt meu_documento.txt”.

Esses são apenas alguns dos comandos básicos que você pode usar para manipular arquivos usando o prompt de comando do Windows.

GIT Comandos Básicos

O Git é uma ferramenta de controle de versão de código fonte amplamente utilizada no desenvolvimento de software. Ele permite que os desenvolvedores trabalhem juntos em um mesmo projeto e acompanhem as alterações realizadas em cada etapa do desenvolvimento. Neste artigo, apresentaremos os principais comandos do Git, com exemplos em PHP.

Antes de começarmos, é importante ressaltar que é necessário ter o Git instalado em sua máquina. Você pode instalar o Git a partir do site oficial: https://git-scm.com/.

  1. Iniciando um repositório Git

O primeiro passo é iniciar um repositório Git no seu projeto. Para isso, acesse a pasta do projeto via linha de comando e execute o comando:

git init

Esse comando criará um repositório Git na pasta do seu projeto.

  1. Adicionando arquivos ao repositório

Para adicionar arquivos ao repositório, execute o seguinte comando:

git add nome_do_arquivo.php

Você pode adicionar vários arquivos de uma vez, utilizando o caractere coringa (*). Por exemplo, para adicionar todos os arquivos com a extensão .php da pasta atual e subpastas, execute o comando:

git add *.php

Caso você tenha diversos arquivos e pastas para serem adicionados ao próximo commit, utilize  " . " . 

git add .

Desta forma todas as alterações serão adicionadas para o próximo commit sem a necessidade de fazer um a um ou por tipos.
  1. Realizando um commit

O commit é a ação de registrar as alterações realizadas em um conjunto de arquivos no repositório. Para realizar um commit, execute o seguinte comando:


git commit -m "Mensagem de descrição das alterações realizadas"


O texto entre as aspas é a mensagem que descreve as alterações realizadas no conjunto de arquivos.

Quando você tenta fazer um commit no Git pela primeira vez, normalmente aparece uma mensagem pedindo para configurar sua identidade. Isso acontece porque o Git precisa registrar quem fez o commit.

git config --global user.email "you@example.com"
git config --global user.name "Your Name"

Isso ocorre porque cada commit guarda duas informações importantes:

👤 Nome do autor

📧 Email do autor

Esses dados ficam registrados no histórico do repositório.

Se você quiser definir autor diferente para um projeto específico, execute dentro da pasta do repositório:

git config user.name "Outro Nome"
git config user.email "outro@email.com"

ou 

git config --local user.name "Outro Nome"
git config --local user.email "outro@email.com"
  1. Visualizando o histórico de commits

Para visualizar o histórico de commits realizados no projeto, execute o seguinte comando:

git log

Para informações mais detalhadas use :
git reflog

Esse comando exibirá uma lista com os commits realizados, com informações como o autor, a data e a mensagem do commit.

  1. Desfazendo alterações em um arquivo

Caso você tenha realizado alterações em um arquivo que não deseja mais manter, é possível desfazê-las utilizando o comando:

git checkout nome_do_arquivo.php

Esse comando desfaz as alterações realizadas no arquivo e volta à última versão commitada.

  1. Trabalhando com branches

O Git permite que você trabalhe em diferentes branches (ramificações) do seu projeto. Para criar uma nova branch, execute o comando:

git branch nome_da_branch

Para alternar para uma branch já existente, execute o comando:

git checkout nome_da_branch

Você pode também criar uma nova branch e alternar para ela em um único comando:

git checkout -b nome_da_branch

Para remover uma branch utilize o comando :
git branch -d nome_da_branch
  1. Integração com o GitHub

O GitHub é uma plataforma de hospedagem de repositórios Git, muito utilizada no mundo do desenvolvimento de software. Para integrar o seu repositório Git com o GitHub, siga os seguintes passos:

  1. Crie um repositório no GitHub.
  2. Adicione o repositório remoto ao seu projeto Git, utilizando o comando:
git remote add origin https://github.com/seu_usuario/nome_do_repositorio.git

Substitua “seu_usuario” pelo seu nome de usuário no GitHub e “nome_do_repositorio” pelo nome do repositório que você criou e envie.

  1. git pull

O comando git pull é utilizado para obter e mesclar as alterações de um repositório remoto para o repositório local. Ele é uma combinação dos comandos git fetch e git merge.

Exemplo:

git pull origin main

Este comando busca as alterações no ramo principal do repositório remoto “origin” e mescla as alterações no ramo local atual.

  1. git clone

O comando git clone é utilizado para criar uma cópia de um repositório remoto para o repositório local.

Exemplo:

git clone https://github.com/usuario/repositorio.git

Este comando cria uma cópia do repositório remoto em uma pasta chamada “repositorio” no diretório atual.

Para recuperar as alterações de um arquivo modificado porém ainda não “commitado”, use o comando a seguir:

git restore nome_do_arquivo

Para alterar a ultima mensagem enviada em um commit use o comando a seguir:

git commit –amend -m “nova_mensagem”

11. Conflitos

Ao abrir um arquivo e este estiver com marcações do tipo

<<<<<<<< HEAD

seu conteúdo…

========

seu conteudo remoto

>>>>>>>> numero_hash(commit)

Este indica um conflito onde você deve escolher qual dos conteúdos deve ficar no arquivo. Para isso, apague todas as marcações e apague o conteúdo que vc deseja remover, deixando somente o seu conteúdo no arquivo. Siga com um novo processo de commit

Conclusão

O Git é uma ferramenta fundamental para gerenciamento de código fonte em projetos de desenvolvimento de software. Com estes principais comandos do Git, você poderá facilmente gerenciar seu repositório e colaborar com outros desenvolvedores. Além disso, o Git tem uma grande comunidade de usuários e é suportado por muitas ferramentas de integração contínua e outras ferramentas de desenvolvimento.